Como transformar foto em vídeo sem o efeito gelatina
Resumo
Para transformar foto em vídeo, escolhe uma imagem com um sujeito claro e alguma profundidade, carrega-a num modelo de imagem para vídeo como primeiro fotograma e escreve um prompt com apenas duas cláusulas: um movimento de câmara e um movimento do sujeito. Gera cerca de cinco segundos, itera a semente ou simplifica o prompt e depois corta, dá cor e acrescenta som. Clips curtos e um só movimento mantêm rostos e detalhes estáveis.
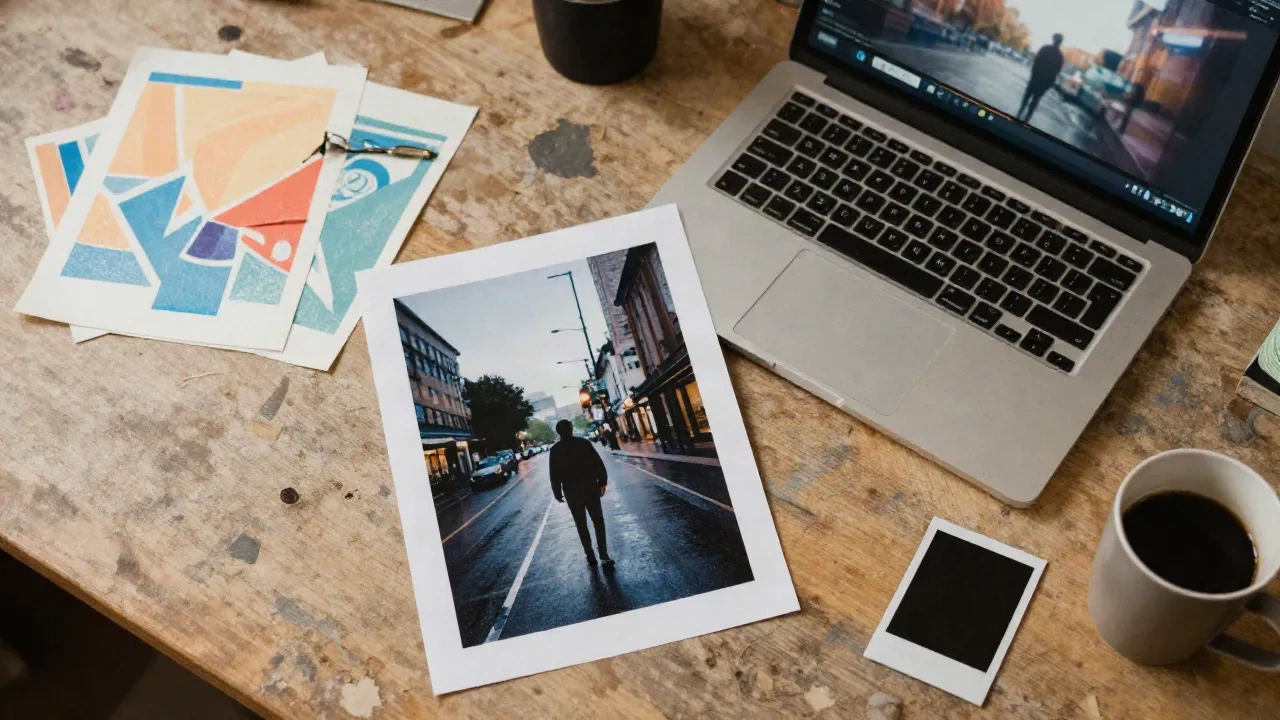
Tens uma imagem de que gostas e queres que se mexa. Para transformar foto em vídeo, faz quatro movimentos: escolhe um fotograma que aguente o movimento, carrega-o num modelo de imagem para vídeo, escreve um movimento de câmara e um movimento do sujeito e gera em curto para depois iterar. É o ciclo inteiro. O resto deste artigo explica o que faz com que resulte à segunda tentativa e não à décima segunda.
As ferramentas pesam menos do que pensas. O fotograma e o prompt pesam mais.
Porque é que a maioria das tentativas parece gelatina
Carregaste uma foto de Flux espetacular, escreveste "faz isto cinematográfico" e, aos dois segundos, a cara derreteu. Toda a gente passou por isto. As falhas agrupam-se sempre nas mesmas três causas, seja qual for o modelo.
A primeira é um fotograma sobrecarregado: seis mãos, uma multidão, texto num letreiro, um reflexo numa montra. A segunda é um prompt que pede três coisas de uma vez. A terceira é um clip demasiado longo para o modelo manter o sujeito coeso.
Nada disto é problema do modelo. É problema do briefing. Fica com esta ideia: a imagem é o teu primeiro fotograma, não o filme acabado.
Escolhe uma imagem que consiga mexer-se
Nem toda a imagem merece movimento. Antes de carregar, faz uma verificação de dez segundos.
Um sujeito claro, com espaço à volta.
Profundidade legível: primeiro plano, meio e fundo.
Nada que o modelo tenha de inventar do zero, como mãos escondidas ou texto.
Composições largas e calmas animam melhor: uma figura numa rua molhada pela chuva, um porto ao amanhecer, um caminho na floresta. Recortes apertados de mãos a segurar objetos são a armadilha clássica.
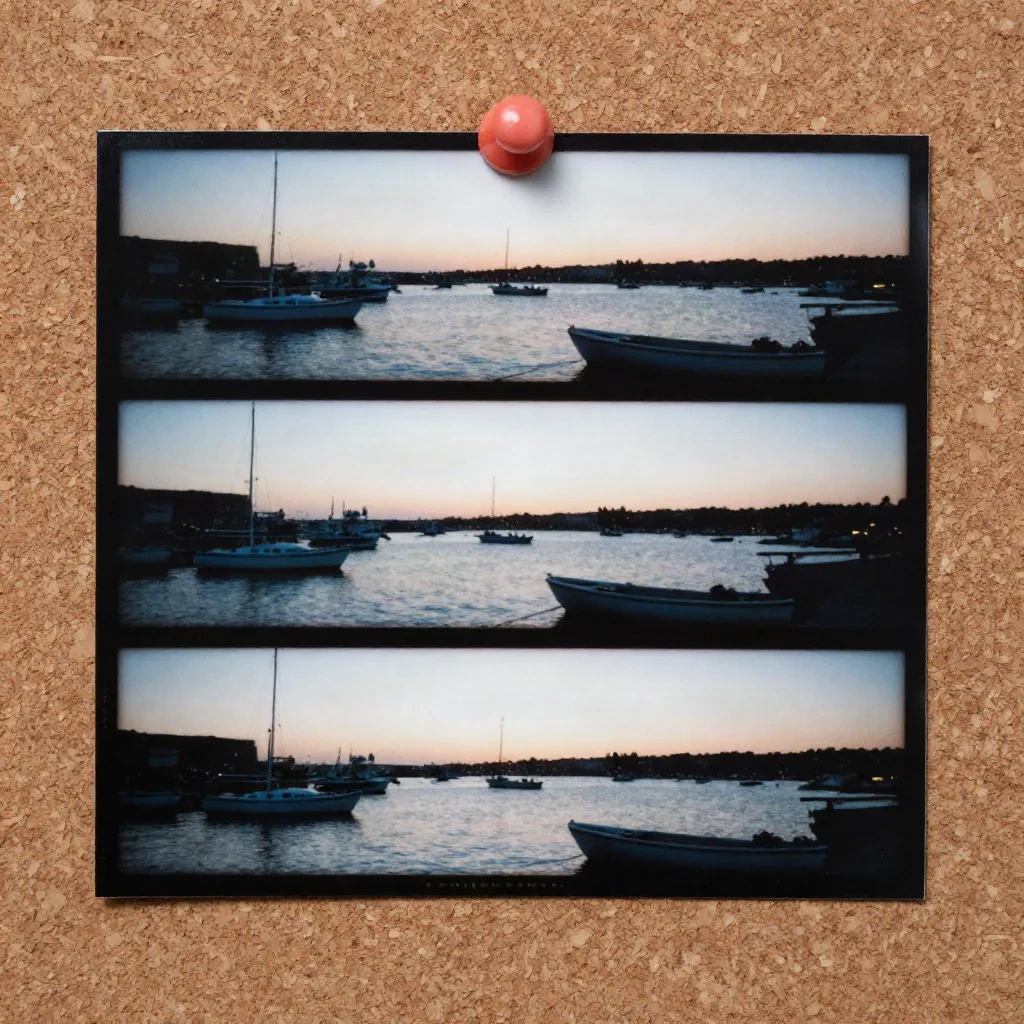
Essa tira é o modelo mental. Um vídeo são apenas fotogramas que diferem um pouco. Se a tua imagem dá ao modelo uma diferença pequena e óbvia para fazer (barcos a derivar, luz a mudar, um casaco a mexer-se), já estás a meio caminho.
O ciclo de quatro passos para transformar foto em vídeo
Este é o fluxo que usamos de facto, independentemente da ferramenta.
Carrega a imagem como primeiro fotograma. Mantém a proporção em que vais publicar. Recortar depois desperdiça pixels.
Escolhe o modelo para o trabalho. Movimento humano e tecido? O Kling é o que as pessoas procuram. Controlo fino e pincel de movimento? Runway. Consistência de produto e logótipo? Várias listas apontam para o Seedance. Não cases com um modelo só.
Escreve o movimento, não a imagem. O modelo já vê a imagem. Descrevê-la outra vez são palavras perdidas.
Gera curto e depois estende. Cinco segundos primeiro. Se aguentarem, avança para mais.
A maioria dos front-ends já tem um campo para primeiro fotograma e alguns aceitam também um último fotograma. O fluxo de imagem para vídeo do Firefly da Adobe é um exemplo limpo: carregas o primeiro fotograma, opcionalmente acrescentas o último, escolhes o movimento de câmara e só depois escreves o prompt. A lógica é a mesma em todo o lado.
Se não quiseres escolher um modelo às cegas, um agregador é o atalho inteligente. O Higgsfield põe vários modelos de vídeo e imagem de ponta atrás de um só login, o que ajuda quando queres passar a mesma imagem por dois motores e comparar.
Escreve o prompt: um movimento de câmara e um movimento do sujeito
Esta é a secção que te poupa créditos. Um bom prompt de imagem para vídeo tem duas cláusulas, e só duas.
Câmara: o que a câmara virtual faz. Sujeito: o que se mexe dentro do enquadramento.
"Travelling lento para a frente. O vapor sobe do café, a figura roda ligeiramente a cabeça." É um briefing completo.
O erro é empilhar. Um guia de prompts de vídeo com IA de 2026 da SurePrompts diz sem rodeios: indica um ou dois comportamentos de câmara por clip, porque pedir ao mesmo tempo um travelling, um foco de mudança, um pan e uma inclinação faz o modelo tirar uma média confusa. Concordamos, e iríamos mais longe. Escolhe um.
Vocabulário que funciona entre modelos:
Aproximação (dolly in): intimidade, ênfase.
Afastamento (pull out): revelação, isolamento.
Órbita: plano de herói para um produto ou personagem.
Câmara estática: quando o movimento do sujeito é a história.
O movimento com motivo bate o movimento decorativo. Pergunta-te porque é que a câmara se mexe. Para seguir uma ação, para revelar algo fora do enquadramento, para empurrar em direção a uma emoção. Se a resposta for "porque fica bem", deixa-a estática e deixa as nuvens fazer o trabalho.
Mete o prompt no Kling ou no motor que usares e vê o que acontece nos primeiros dois segundos. Dizem-te quase tudo.
Padrões de prompt que continuamos a copiar
Três estruturas que sobrevivem a qualquer motor. Remistura se quiseres, mas começa por aqui.
A foto viva e calma. "Câmara estática. O vento mexe a relva e o cabelo, a luz treme um pouco. Tudo o resto fica parado." Ótimo para retratos e paisagens. Risco baixo, retorno alto.
A revelação. "Afastamento lento do rosto do sujeito para mostrar a sala vazia atrás. Deriva suave de câmara à mão." Útil quando a tua imagem está muito apertada e queres contexto.
A órbita. "Órbita suave de 360 graus à volta do objeto, a raio constante, enquadramento consistente, sem zoom." Usa para produtos e sujeitos escultóricos, e conta com repetir.
Repara no que falta: adjetivos como "épico", "deslumbrante", "obra-prima". Não fazem nada. Os verbos é que trabalham.
O Kling ganha a reputação exatamente aqui: movimento de câmara credível, mais física em tecidos, cabelo e líquidos. Se a tua imagem tiver um casaco, um vestido ou uma chávena de chá, testa primeiro o Kling.
Mantém a cara, o logótipo e a paleta intactos
A consistência é onde a imagem para vídeo parte corações. Três hábitos ajudam.
Diz o que não pode mudar. "A cara e a roupa mantêm-se estáveis, sem deformações, fundo estático." Soa a aviso legal, mas resulta mais vezes do que não.
Encurta o clip. A deriva cresce com a duração. Cinco segundos que aguentam batem dez segundos que oscilam. Podes sempre juntar clips.
Usa uma segunda imagem como último fotograma quando a ferramenta o permitir. Deixas de pedir ao modelo que adivinhe onde o plano acaba. Dizes-lhe tu, e ele só tem de ligar os pontos.
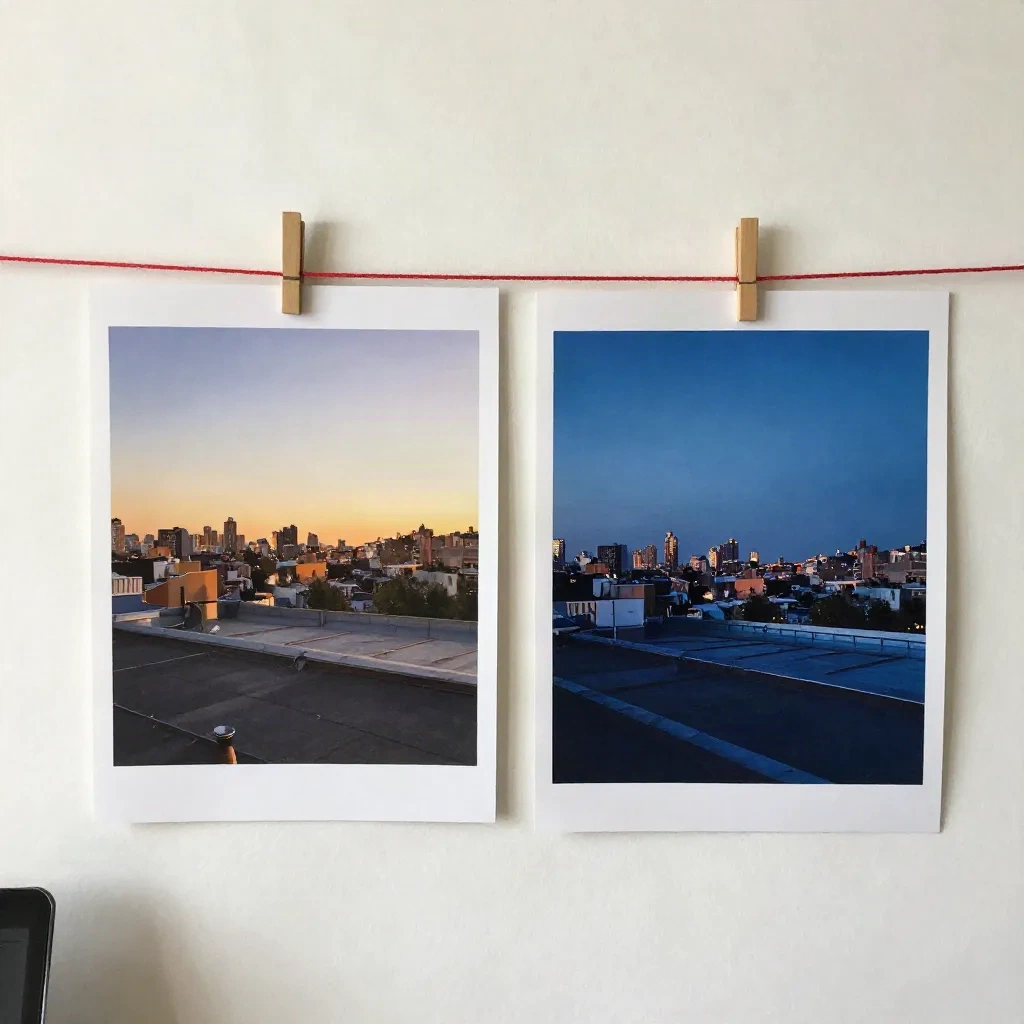
Esse par de telhados é um setup perfeito de início e fim. Da hora dourada para a hora azul, mesmo enquadramento. Gera a segunda imagem com a mesma semente ou referência e a interpolação faz algo genuinamente bonito em vez de inquietante.
O que saltar e o que fazer quando quase está certo
Opinião. Algumas dicas populares raramente compensam na prática.
Salta o botão de "animar" com um clique para tudo o que importa. Serve para um meme e é uma aposta numa entrega de cliente. A rota do prompt personalizado custa-te trinta segundos e poupa-te três regerações.
Salta os clips longos na primeira passagem. Cada segundo extra multiplica a probabilidade de a cara derivar.
Salta os prompts que redescrevem a imagem. O modelo já tem a imagem. Gasta as palavras no movimento.
Salta a perseguição do 4K antes de o movimento funcionar. Amplia o vencedor, nunca a experiência.
Quase certo é o estado normal do vídeo com IA. Corrige por ordem de custo, do mais barato para o mais caro.
Muda a semente ou volta a gerar. Correções gratuitas primeiro.
Corta o prompt a metade. Menos instruções, menos conflitos.
Troca o movimento de câmara por "câmara estática" e mexe só o sujeito.
Experimenta outro modelo com a mesma imagem e o mesmo prompt curto.
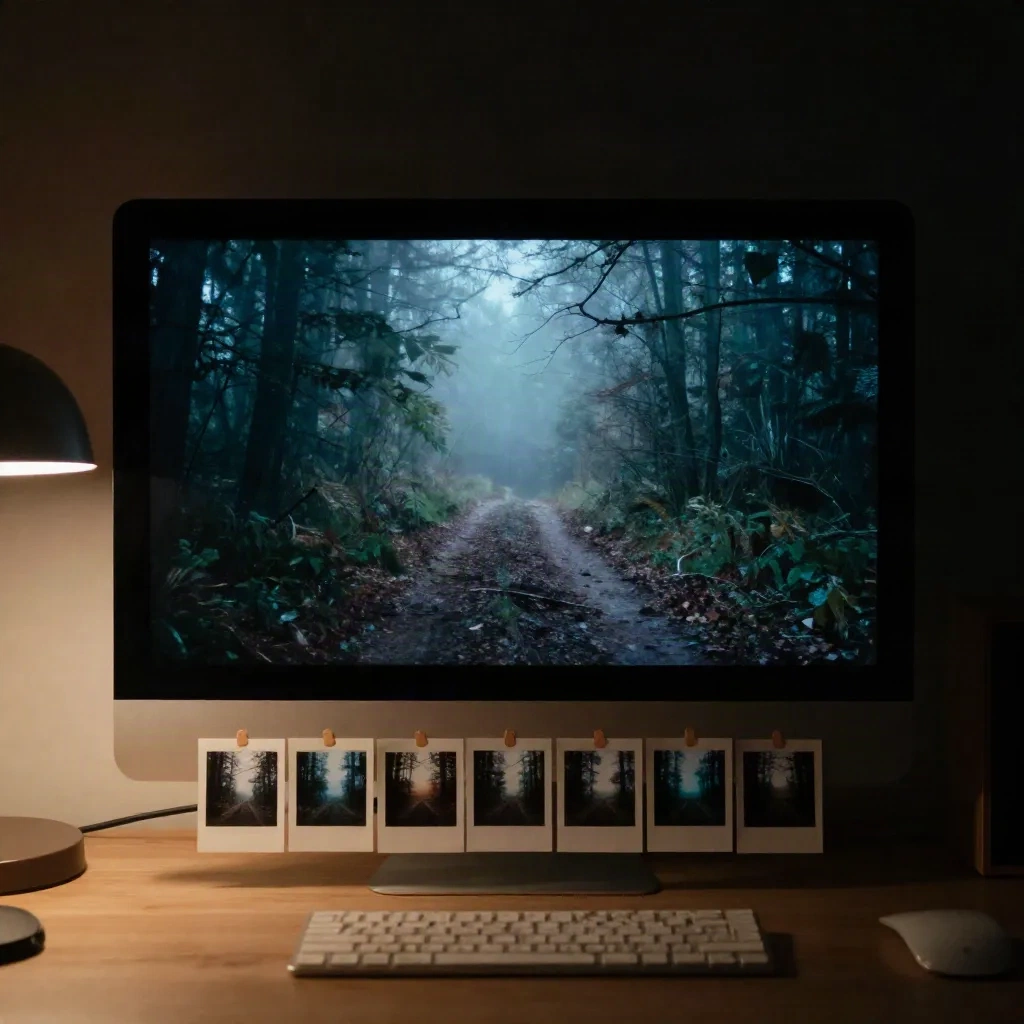
Guarda os que resultaram. Uma prateleira de fotogramas em pausa e clips favoritos torna-se o teu próprio moodboard, do tipo de canal no Are.na a que voltas de facto. Com o tempo aprendes quais as imagens que se mexem bem e quais ficam ali a olhar para ti.
Acabamento e formato: o que fazer antes e depois de gerar
Acabamento. Um clip cru é um clip, não uma peça. Corta meio segundo no início e no fim, onde o modelo costuma oscilar. Dá uma cor ligeira para que clips de modelos diferentes pareçam família. Acrescenta som, porque o silêncio denuncia a IA mais depressa do que qualquer artefacto.
O CapCut trata do corte, das legendas e da camada de som sem te obrigar a abrir um editor pesado. Chega para as redes sociais e começa de graça.
Se estiveres a construir uma peça mais longa a partir de várias imagens, por exemplo um reel de moodboard com cenas que se seguem, uma ferramenta de guião para vídeo pode fazer a montagem por ti.
O TopView aceita um URL ou um guião e monta um vídeo com várias cenas. É outro trabalho do que animar uma imagem única, mas útil quando a tua imagem é um de muitos recursos e precisas de uma montagem rápida.
Formato. Onde o vídeo vai viver decide como a imagem deve ser enquadrada, por isso resolve isto primeiro. Um clip vertical 9:16 para Reels ou Shorts quer o sujeito centrado com espaço acima, porque a interface da plataforma tapa as margens. Um clip 16:9 para o herói de um site quer espaço para respirar à esquerda ou à direita, para que um pan lento tenha para onde ir. O quadrado fica no meio e perdoa quase tudo.
Se a tua imagem de origem tiver a forma errada, regenera-a ou faz outpainting antes do passo do vídeo. Deixar o modelo de vídeo preencher as margens sozinho é como acabas com um céu esticado e um horizonte torto. A resolução funciona da mesma forma: uma imagem nítida em 1080p bate uma ampliação 4K desfocada, porque o modelo lê detalhe, não número de pixels. Limpa a imagem primeiro, anima depois.
Imagens geradas por IA contra fotos reais. Funcionam as duas, e falham de maneiras diferentes. As imagens de Midjourney ou Flux são fáceis de animar porque já estão limpas, centradas e bem iluminadas. O ponto fraco é o disparate escondido: um sétimo dedo, um letreiro ilegível. O movimento torna esses erros impossíveis de ignorar, por isso amplia a 200 por cento e corrige a imagem antes de a animar.
As fotos reais têm profundidade e textura honestas, mas vêm com desarrumação. Fundos ocupados, sombras duras e ruído de compressão confundem o modelo. Recorta de forma apertada num só sujeito, uniformiza a exposição, e o resultado costuma acertar.
Para impressões antigas de família e negativos digitalizados, mantém o prompt mais suave do que imaginas. Um aproximar lento e um leve respirar chegam. Qualquer coisa mais ousada tende a acordar um rosto que não querias acordado.
Algumas imagens são melhores como imagens. Se a imagem já diz tudo, um pan a oscilar só lhe tira qualquer coisa. Anima quando o movimento acrescenta informação: tempo, uma revelação, um gesto, a rotação de um produto. Deixa-a quieta quando a quietude é o ponto.
Por isso, pega numa imagem da tua última sessão no Midjourney ou no Flux, escreve uma cláusula de câmara e uma cláusula de sujeito, e gera cinco segundos. Depois conta o que aconteceu nos primeiros dois segundos. Esse é o teste inteiro.