Zamiana zdjęcia w wideo bez efektu galarety: 4 kroki
Summary
Żeby zrobić zamianę zdjęcia w wideo, wybierz kadr z jednym wyraźnym podmiotem i odrobiną głębi, wgraj go do modelu image-to-video jako pierwszą klatkę i napisz dwie klauzule: jeden ruch kamery oraz jeden ruch postaci. Generuj najpierw pięć sekund, nie opisuj ponownie obrazu i trzymaj twarz, logo oraz kolory w spokoju. Dopiero gdy ruch działa, dopracuj wykończenie w montażu i dopiero wtedy podbij rozdzielczość.
Masz kadr, który kochasz, i chcesz, żeby się ruszał. Zamiana zdjęcia w wideo idzie w czterech krokach: wybierasz klatkę, która przetrwa ruch, wrzucasz ją do modelu image-to-video, piszesz jeden ruch kamery i jeden ruch postaci, a potem generujesz krótko i poprawiasz. To cała pętla. Reszta tego tekstu to to, co sprawia, że działa za drugim razem, a nie za dwunastym.
Narzędzia znaczą mniej, niż myślisz. Klatka i prompt znaczą więcej.
Skąd bierze się efekt galarety? Masz śliczny still z Flux, wpisujesz „zrób to kinowo” i na drugiej sekundzie twarz się rozpływa. Znamy to wszyscy. Porażki zwykle mają trzy przyczyny, niezależnie od modelu. Klatka była przeładowana: sześć dłoni, tłum, napis na szyldzie, odbicie w szybie. Prompt żądał trzech rzeczy naraz. Klip trwał za długo, żeby model utrzymał postać w kupie.
To nie problem modelu, tylko briefu. Przyjmij prostą myśl: obraz to twoja pierwsza klatka, a nie gotowy film.
Zauważ, że żadna z tych przyczyn nie wymaga droższego narzędzia. Ten sam still w trzech różnych silnikach potrafi dać trzy różne wyniki, i zwykle nie chodzi o cenę, tylko o to, co wrzuciłeś na wejściu.
Wybierz kadr, który umie się ruszać
Nie każdy obraz zasługuje na ruch. Zanim cokolwiek wrzucisz, zrób dziesięciosekundowy test:
jeden wyraźny podmiot z oddechem wokół,
czytelną głębię: pierwszy plan, środek, tło,
nic, co model musi wymyślić od zera, na przykład ukrytych dłoni albo tekstu.
Szerokie, spokojne kompozycje animują się najlepiej. Postać na mokrej ulicy, port o świcie, leśna ścieżka. Ciasne kadry dłoni trzymających przedmioty to klasyczna pułapka.
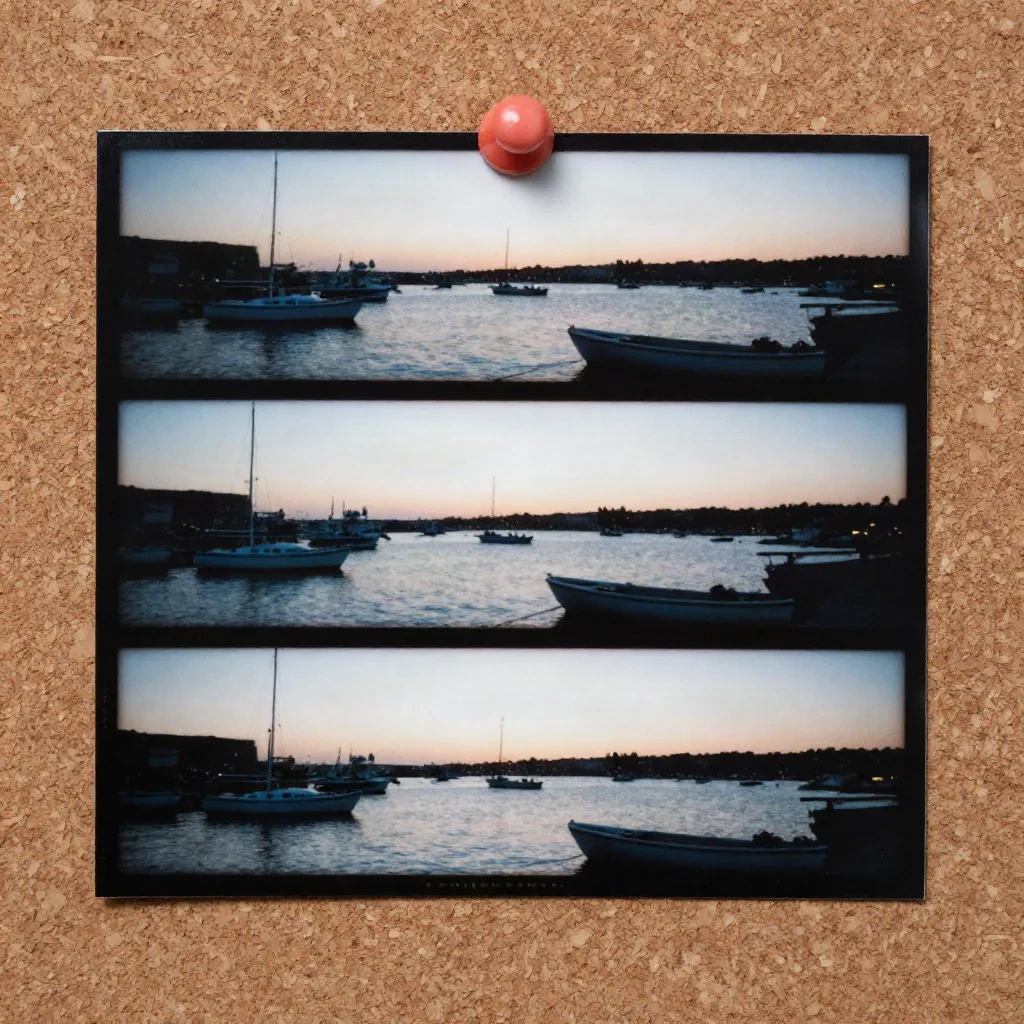
Ten pasek to dobry model myślowy. Wideo to po prostu klatki, które różnią się odrobinę. Jeśli twój still daje modelowi oczywistą drobną zmianę (łódka dryfuje, światło się przesuwa, płaszcz się porusza), jesteś w połowie drogi.
Czteroetapowa pętla
Oto proces, którego sami używamy. Działa niezależnie od narzędzia:
Wrzuć still jako pierwszą klatkę. Zostaw proporcje, w których zamierzasz publikować. Kadrowanie później marnuje piksele.
Wybierz model do zadania. Ruch człowieka i tkanin? Po Kling sięga większość. Precyzyjna kontrola i pędzel ruchu? Runway. Spójność produktu i logo? Kilka zestawień stawia na Seedance. Nie żeń się z jednym modelem.
Opisz ruch, nie obraz. Model już widzi obraz. Opisywanie go znowu to słowa wyrzucone w błoto.
Generuj krótko, potem wydłużaj. Najpierw pięć sekund. Jeśli się trzymają, idź dalej.
Większość frontendów ma już slot na pierwszą klatkę, a niektóre przyjmują też ostatnią. Przepływ image-to-video w Adobe Firefly to czysty przykład: wgrywasz klatkę startową, opcjonalnie końcową, wybierasz ruch kamery i dopiero piszesz prompt. Ta sama logika działa wszędzie.
Pętla ma jedną zaletę: zawsze zaczynasz od tego samego pytania. Czy ten kadr zniesie ruch? Jeśli tak, reszta to już tylko iteracja. Jeśli nie, żadna ilość promptów tego nie naprawi, więc wracasz do kroku pierwszego.
Jeśli nie chcesz wybierać modelu w ciemno, agregator to leniwie-sprytna droga. Higgsfield trzyma kilka czołowych modeli wideo i obrazu za jednym logowaniem. Wygodne, kiedy chcesz przepuścić ten sam still przez dwa silniki i porównać wyniki.
Prompt: jeden ruch kamery, jeden ruch postaci
To ta sekcja, która oszczędza kredyty. Dobry prompt image-to-video ma dwie klauzule i tylko dwie.
Kamera: co robi wirtualny obiektyw. Postać: co się rusza w kadrze.
„Powolny dolly-in. Z kawy unosi się para, postać lekko odwraca głowę.” To kompletny brief.
Błąd to nakładanie. Przewodnik SurePrompts o promptowaniu wideo AI z 2026 roku mówi wprost: nazwij jedno albo dwa zachowania kamery na klip, bo gdy prosisz naraz o dolly, rack focus, panoramę i pochylenie, model uśrednia je w mętny dryf. Zgadzamy się, a nawet pójdziemy dalej. Wybierz jeden.
Słownictwo, które działa w każdym modelu:
Push in / dolly in: bliskość, nacisk.
Pull out: odsłonięcie, izolacja.
Orbit: ujęcie hero dla produktu albo postaci.
Tilt up lub down: skala, odsłonięcie w pionie.
Statyczna kamera: gdy historią jest ruch postaci.
Ruch uzasadniony bije ruch dekoracyjny. Zapytaj siebie, po co kamera się rusza: żeby podążać za akcją, odsłonić coś spoza kadru, popchnąć ku emocji. Jeśli odpowiedź brzmi „bo wygląda fajnie”, zostaw ją w spokoju i pozwól chmurom pracować.
Wrzuć to do Kling albo innego silnika i obserwuj pierwsze dwie sekundy. Mówią prawie wszystko.
Wzorce, które wciąż kopiujemy
Trzy struktury, które przetrwają zmianę silnika. Ukradnij je, a potem remiksuj.
Spokojne żywe zdjęcie. „Statyczna kamera. Wiatr rusza trawę i włosy, światło lekko migocze. Reszta zostaje w miejscu.” Świetne do portretów i pejzaży. Małe ryzyko, duży efekt.
Odsłonięcie. „Powolne odjazdowe ujęcie od twarzy postaci, żeby pokazać pusty pokój za nią. Miękki, ręczny dryf.” Dobre, gdy still jest ciasny, a ty chcesz kontekstu.
Orbita. „Płynna orbita 360 stopni ze stałym promieniem wokół obiektu, stały kadr, bez zoomu.” Do produktów i rzeźbiarskich form. Licz się z tym, że trzeba będzie spróbować ponownie.
Zauważ, czego brakuje: przymiotników w stylu „epicki”, „oszałamiający”, „arcydzieło”. Nic nie robią. Robią czasowniki.
Dobry test jest prosty. Jeśli prompt przeczytasz na głos w pięć sekund i każda klauzula opisuje coś, co widać w kadrze, jest w porządku. Jeśli trzeba go czytać dwa razy, zacznij od skrócenia.
Kling zdobył reputację właśnie tym: wiarygodnym ruchem kamery i fizyką tkanin, włosów i cieczy. Jeśli twój still ma płaszcz, sukienkę albo filiżankę herbaty, testuj Kling jako pierwszy.
Twarz, logo i kolory bez zmian
Spójność to miejsce, w którym zamiana zdjęcia w wideo potrafi złamać serce. Trzy nawyki pomagają.
Powiedz, czego nie wolno zmienić. „Twarz i strój pozostają stabilne, bez deformacji, tło statyczne.” Brzmi jak klauzula z umowy, ale działa częściej, niż nie.
Pamiętaj też o oświetleniu. Jeśli still ma mocne światło z jednej strony, prompt, który każe „zmienić porę dnia”, zwykle kończy się konfliktem: model próbuje jednocześnie zachować i zmienić to samo światło. Trzymaj się jednej zmiany naraz: albo ruch, albo nastrój.
Skróć klip. Dryf rośnie z czasem. Pięć sekund, które się trzymają, bije dziesięć, które się chwieją. Resztę możesz zszyć.
Użyj drugiego stilla jako klatki końcowej, jeśli narzędzie to obsługuje. Nie zgadujesz już, gdzie ujęcie się kończy. Mówisz modelowi, a on tylko łączy kropki.
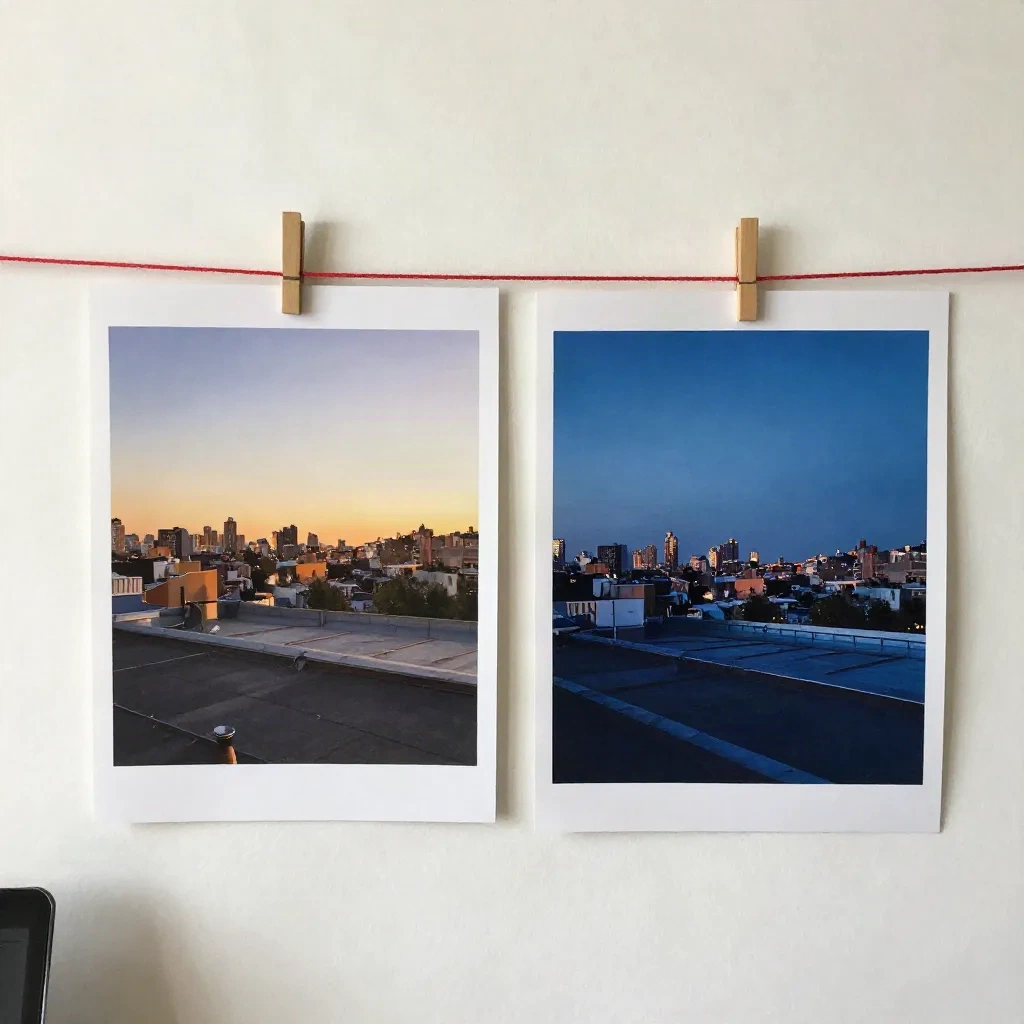
Ta para dachów to idealny zestaw start i koniec. Złota godzina przechodzi w niebieską, kadr zostaje ten sam. Wygeneruj drugi still z tym samym seedem albo referencją, a interpolacja zrobi coś naprawdę pięknego zamiast czegoś niepokojącego.
Czego nie rób i co zrobić, gdy ruch jest prawie dobry
Opinia bez owijania. Kilka popularnych porad rzadko się opłaca:
Nie używaj jednym kliknięciem „animuj” przy czymś ważnym. Do memów w porządku, przy materiale dla klienta to hazard. Własny prompt kosztuje trzydzieści sekund i oszczędza trzy regeneracje.
Nie rób długich klipów na pierwszym przejściu. Każda dodatkowa sekunda mnoży szansę, że twarz odpłynie.
Nie opisuj znowu obrazu. Model go ma. Słowa wydaj na ruch.
Nie goń za 4K, zanim ruch działa. Podbij rozdzielczość zwycięzcy, nigdy eksperymentu.
Prawie dobrze to normalny stan wideo AI. Naprawiaj od najtańszego:
Zmień seed albo po prostu wygeneruj ponownie. Darmowe poprawki najpierw.
Przetnij prompt na pół. Mniej poleceń, mniej konfliktów.
Zamień ruch kamery na „statyczna kamera” i rusz tylko postacią.
Spróbuj innego modelu z tym samym stillem i tym samym krótkim promptem.
Jest jeszcze jeden błąd, który widzimy najczęściej: poprawianie wszystkiego naraz. Zmieniasz kamerę, prompt, model i seed w jednym podejściu, a potem nie wiesz, co zadziałało. Zmieniaj jedną rzecz na raz i notuj wynik. Brzmi nudno, ale to jedyny sposób, żeby po tygodniu wiedzieć, czego się trzymać.
Zachowuj te, które wyszły. Półka zatrzymanych klatek i ulubionych klipów staje się własnym moodboardem, takim, do którego naprawdę wracasz. Z czasem nauczysz się, które kadry się ruszają, a które tylko siedzą i patrzą na ciebie spode łba.
Wykończenie i dobór formatu
Surowa generacja to klip, nie utwór. Utnij pierwsze i ostatnie pół sekundy, gdzie model zwykle się chwieje. Dodaj lekką gradację, żeby klipy z różnych modeli brzmiały jak jedna rodzina. Dodaj dźwięk, bo cisza zdradza AI szybciej niż jakikolwiek artefakt.
CapCut załatwia cięcie, napisy i warstwę dźwięku bez otwierania ciężkiego edytora. Do social mediów wystarczy, a na start jest darmowy.
Jeśli składasz dłuższą całość z kilku stilli, na przykład reel z moodboardu ze scenami, które następują po sobie, narzędzie do zamiany skryptu na wideo zrobi zszywanie za ciebie.
TopView bierze URL albo skrypt i składa wielosceniowe wideo. To inna praca niż animacja jednego stilla, ale przydatna, gdy twój obraz jest jednym z wielu zasobów i potrzebujesz szybkiego montażu.
Zanim wrzucisz, ustal, gdzie wideo będzie żyć, bo to determinuje kadr. Pionowy klip 9:16 na Reels albo Shorts potrzebuje podmiotu na środku z zapasem nad głową, bo interfejs platformy zasłania brzegi. Klip 16:9 do hero na stronie potrzebuje oddechu z lewej albo prawej, żeby powolny pan miał dokąd jechać. Kwadrat jest pośrodku i wybacza prawie wszystko.
Jeśli obraz źródłowy ma zły kształt, wygeneruj go ponownie albo rozszerz (outpaint) przed krokiem wideo. Pozwalanie modelowi wideo samemu dopełniać brakujące krawędzie kończy się rozciągniętym niebem i krzywym horyzontem.
Z rozdzielczością jest tak samo. Ostry 1080p bije rozmyty upscale 4K, bo model czyta detal, a nie liczbę pikseli. Najpierw oczyść still, potem animuj.
Przy zszywaniu pamiętaj o rytmie. Krótkie ujęcia po trzy, cztery sekundy czytają się jak moodboard w ruchu. Dłuższe ujęcia wymagają lepszego stilla i mniej ruchu, bo tam każdy dryf widać od razu.
Obrazy AI, prawdziwe zdjęcia i pytanie: animować czy nie?
Oba działają, ale psują się inaczej.
Obrazy AI z Midjourney czy Flux dobrze znoszą animację, bo są już czyste, wycentrowane i dobrze oświetlone. Ich słaby punkt to ukryte bzdury: siódmy palec, zlepiony napis. Ruch czyni te błędy nie do przeoczenia, więc powiększ do 200% i napraw still, zanim go animujesz.
Prawdziwe zdjęcia mają uczciwą głębię i fakturę, ale przychodzą z bałaganem. Zatłoczone tła, ostre cienie i szum kompresji mylą model. Utnij ciasno na jeden podmiot, wyrównaj ekspozycję i zwykle wychodzi.
Stare rodzinne odbitki i zeskanowany film: trzymaj prompt łagodniejszy, niż ci się wydaje. Powolny najazd i odrobina oddechu wystarczą. Wszystko odważniejsze potrafi obudzić twarz, której nie chciałeś budzić.
Jeśli pracujesz na zdjęciach z telefonu, zwróć uwagę na stabilizację i kompresję. Mocno skompresowany plik to mniej detalu do odczytania przez model, a im mniej detalu, tym łatwiej o drobne pływanie tekstur w ruchu.
Ostatnie uczciwe pytanie. Niektóre obrazy są lepsze jako obrazy. Jeśli still już wszystko mówi, chwiejny pan tylko coś z niego odbierze.
Animuj, gdy ruch dokłada informacji: pogodę, odsłonięcie, gest, obrót produktu. Zostaw w spokoju, gdy nieruchomość jest sensem.
Weź jeden obraz z ostatniej sesji w Midjourney albo Flux, napisz jedną klauzulę o kamerze i jedną o postaci, wygeneruj pięć sekund. Potem napisz, co zrobiły pierwsze dwie sekundy. To cały test.