AI 動画プロンプト: 3秒以降も持ちこたえるプロンプトの書き方
要約
良いAI動画プロンプトは絵を説明しない。ショットを指示する。被写体、アクション、カメラ移動、光、変わらない何か。5つのスロット。1ショット1ムーブ、本物のカメラ言葉、ロック線で背景ドリフトを止める。画像→動画は動きだけ説明。1モデルで学ぶ、1スロットずつ変える、クリップを判定。
AI 動画プロンプト: 3秒以降も持ちこたえるプロンプトの書き方
「何かクールな映像が欲しい」と入力したら、溶けたネオンスープが返ってきた。そんな経験は誰にでもある。良い「AI 動画 プロンプト」は絵を説明しない。ショットを指示する。誰が何をして、カメラがどこに動いて、どのくらい続いて、何が固定されているか。以下は、うまくいくプロンプトから盗んだ5段階の構造と、今すぐVeo、Kling、RunwayにコピーペーストできるAI動画プロンプトの実例を紹介する。
なぜプロンプトは3秒目で崩壊するのか
静止画のプロンプトは一フレームを説明する。動画プロンプトは時間を説明しなければならない。これが全ての違いで、Midjourneyの習慣がビデオボタンを押した瞬間に壊れる理由だ。
見た目だけを説明すると、モデルは動きを発明しなければならない。それは最も怠惰な選択肢を選ぶ。スローズーム、顔がドリフト、背景が静かに再構成される。君は雰囲気を求めたのに、スクリーンセーバーが返ってきた。
修正は退屈だが、効く。被写体、一つのアクション、カメラの動き、光、そして変わらない何か。5つのスロット。一つ欠けると、モデルが埋める。大抵はひどい結果になる。
Googleの公式Veoプロンプトガイドも同じ骨組みに行き着いている。被写体、アクション、スタイル、カメラ位置と動き、構図、雰囲気。これを単純化して、入力しながら頭に入れられるようにしただけ。
5スロット式: コピーして使えるプロンプト
枠組みはこう。1、2文の平明な文で、最初は60語程度に収めて書く。
被写体:2つの具体的な修飾を伴う名詞句。「人」ではなく「黄色いレインジャケットを着た配達員」。
アクション:1つの動詞、1つのビート。「通りを渡って、ちらつく看板の下で止まる」。
カメラ:ショットサイズとムーブ。「ロー・アングル、スロー・プッシュ・イン」。
光とグレード:「街灯の黄色い光、濡れた舗装、35ミリ粒子」。
ロック:変わらないもの。「背景の看板は静止したまま、余分なキャラなし」。
これをコピーしよう:
黄色いレインジャケットを着た配達員が、夜の空いた通りを渡り、ちらつく看板の下で止まる。ロー・アングル、スロー・プッシュ・イン、35ミリフィルム粒子、街灯が濡れた舗装に反射する光。看板と建物は静止したまま、追加キャラなし、テキストなし。
何が抜けているか注目。「エピック」、「傑作」、「8K超詳細」。これらの言葉は画像モデルの時代の遺物で、ノイズを加えるだけで指示を与えない。そのトークンをカメラに使う。
カメラ言語は君が持つ最安値のアップグレード
一つだけ直すなら、ここを直す。モデルは映画用語でラベル付けされた数百万本のクリップを見ているから、本当のカメラ用語は本当の挙動を引き出す。曖昧なものは平均値を引き出す。
実際に出力を変える簡潔なチートシート:
プッシュ・イン / プルバック:最安全な動き。ここから始める。
トラッキング・ショット:カメラが被写体の横または後ろから追う。歩行シーンに最高。
オービット / アーク:強力だが、顔を歪める最も可能性の高い動き。クリップは短く。
スタティック・ロックオフ:過小評価。三脚ショットで被写体だけが動くのが最も安定。
ハンドヘルド:生命感を加える。揺れも加える。「微妙」と言わないと、地震カメラになる。
1クリップに1ムーブ。2つの同時ムーブ(「軌道を描きながらズームアップしてティルトする」)は物理が死ぬ場所だ。複雑な展開が必要なら、別ショットを作って編集で繋ぐ。
画像から動画:動きを説明し、絵は説明しない
静止画から始めるのは、この職人技全体の静かなチート・コードだ。先に画像モデルでルックを固める。その後、アニメーション。動画プロンプトは説明ではなく、ト書きになる。
画像はすでに被写体、光、パレットを含んでいる。繰り返すのはトークンの無駄で、時にはフレームと衝突する。動くものだけ書く:
女性が窓の方へゆっくり頭を向ける。カーテンが軽い微風で揺れる。カメラは固定。フレーム内の他の全てはそのまま。
最後の文は見た目以上に大事だ。「他の全てはそのまま」はドリフト背景に対する安い固定で、AIの動画を見分ける。
Midjourneyやfluxで参照を作っているなら、構図はシンプルに:一つのはっきりした被写体、カメラが動くスペース。窮屈で忙しい静止画は動画モデルに何も安全に押す場所がない。
コピーする価値のあるプロンプト:3つのシーン、3つの仕事
プロンプトライブラリはボリュームを愛する。オレたちは3つをくれる。それぞれが異なる反射を教える。自由にリミックスしても、これから始める。
プロダクト・ビート。短く、制御された、歪む人間なし。
石の台所の机の上のマット陶器マグ、夜明け。湯気が静かに昇る。スロー・プルバックで日中の台所が見える。窓からの柔らかい光、浅い被写界深度。マグの形と机は変わらない。手なし、テキストなし。
ムード・ピース。一キャラ、一ジェスチャー、大気がたっぷり。
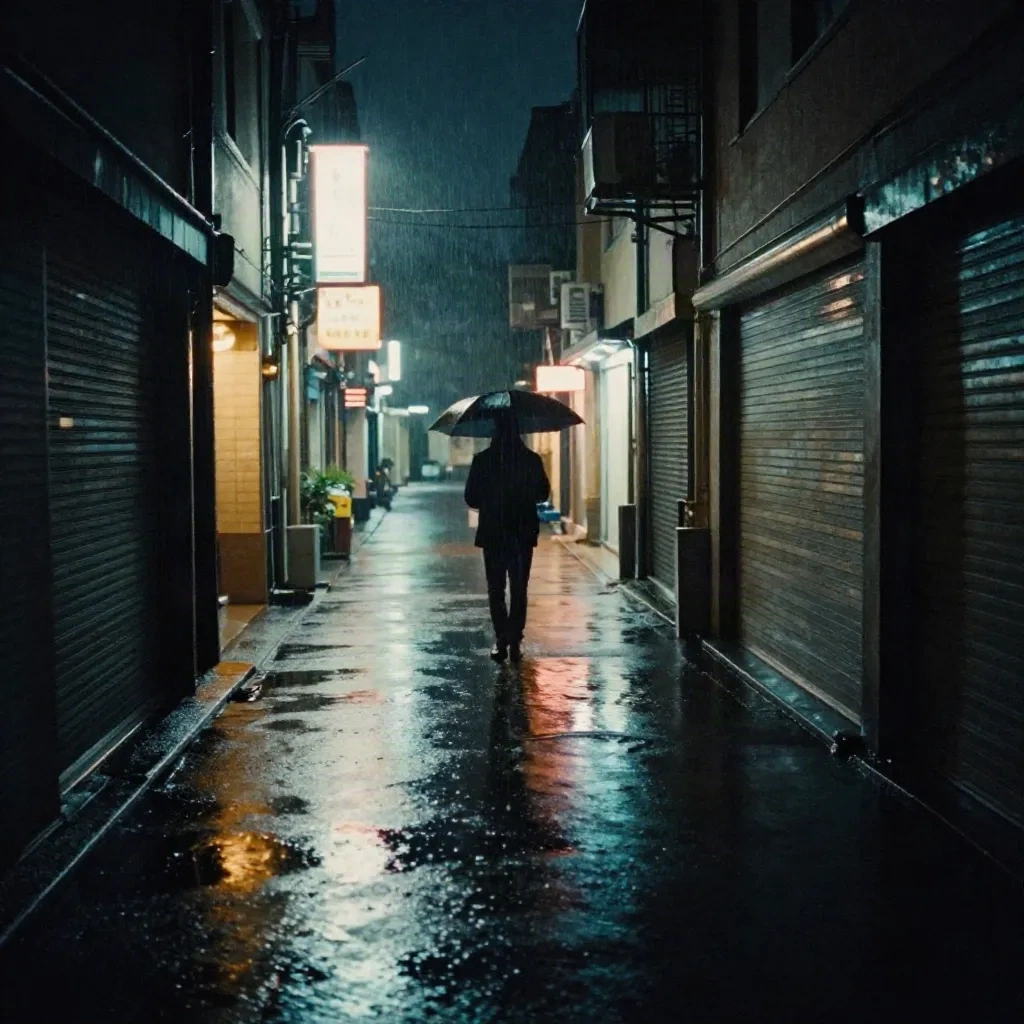
傘をさした孤独な人物が、雨の降る夜のネオン横丁を歩き去る。固定されたワイドショット、アナモルフィック・フレア、大雨、濡れた反射、35ミリ粒子。人物は一定のペースで歩き続ける。カットなし。
ループ。背景、ヒーロー・セクション、シームレスにリプレイする必要があるソーシャル投稿用。
金時間に山頂の上をゆっくり流れる雲、カメラ固定、前景の草に微かなパララックス。柔らかいフィルムグレード。動きは微妙で継続的、スタートフレームと終了フレームは同じに見える。
それぞれが5つのスロットに従う。それぞれが固定で終わる。それが3秒以降も持ちこたえるパターン。
音、長さ、アスペクト比:みんなが忘れるセッティング
3つの詳細は5つのスロットの外にあるが、忘れるとクリップを壊す。
長さ。短いクリップは一体を保つ、長いものはドリフトする。 モデルが5~8秒を提供するなら、1ビートを求めて止める。30秒が必要?6ショットを計画して、1つの英雄的生成ではなく。編集者は1世紀にわたってアクションで切ってきた理由がある。
アスペクト比。書く前に決める。構図はそれに左右される。 スローダーリング・ショットは16:9で美しく、9:16では窮屈に感じる。縦については、被写体を中央の三分線に置いて、インターフェースクロームの頭上スペースを残す。ツールが許すなら、プロンプトに比を言う。
サウンド。一部のモデルは今、動画と同時にオーディオを生成する。 君のモデルがそうなら、ショットのようにサウンドを書く。「遠い交通のシューシュー音、金属の雨音、かすかで圧迫されたサイレン」。音楽リクエストはスキップ。とにかく自分で採点したい。
配達員プロンプトのサウンド付きバージョンはこう:
黄色いレインジャケットを着た配達員が空いた通りを渡り、ちらつく看板の下で止まる。ロー・アングル、スロー・プッシュ・イン、35ミリ粒子、16:9。アンビエント音:一定の雨、遠い交通、看板からかすかな電子音。セリフなし、テキストなし。
同じ5スロット、1行追加。全アップグレード。
どのモデルにどのプロンプト?
同じプロンプト、異なるモデル、異なる結果。ワン・マスター・プロンプトが旅すると期待するな。誠実な一般化いくつか、ベンチマークは偽らず:
Veoは長く、説明的、映画的な文をよく扱い、セリフと音キューを持つことができる。Klingは明確な身体的アクションとカメラ指示に報い、画像から動画に居心地がよい。Runwayはタイトで控えめなプロンプトを好み、反復を開始したら実装ハンドコントロール。
3つのタブを行き来したくなければ、Higgsfieldが1つのワークスペースの後ろに複数のビデオモデルを置く。同じプロンプトを2つのエンジンで実行して比較するときに便利。それが各モデルが実際に何を聞いているかを学ぶ最速の方法。
気取らずに:1つモデルを選んで、1週間その癖を学んで、それから枝分かれ。毎回エンジンをホップしてクリップが失望すると、何も教わらない。
避けるべき習慣(クレジットが余計にかかる)
一部のアドバイスは賢く聞こえるから広がる。スキップ:
品質単語のスタック。 「超リアル、8K、傑作、受賞」は動画をよくしない。指示をまばらにする。
長い小説のようなプロンプト。 100語を過ぎると、モデルは初期の詳細をドロップ。短く具体的が長く詩的に勝つ。
フレームにテキストを求める。 署名、字幕、ロゴは通常、クリップの中盤に歪む。編集で題名を追加。
1クリップで5アクション。 5秒は1ビートに収まる。残りを別生成に分割。
毎回ゼロから書き直す。 一つ働くプロンプトを保つ、1スロット変更、比較。それが実験。
クレジットを焼かずに反復する
各生成をテストとして扱え。宝くじではない。一度に1スロットを変更。動きが間違っているなら、アクション行に触れる。見た目がドリフトするなら、ロックをタイト。カメラがフローティングするなら、「オービット」を「スロー・プッシュ・イン」に交換。
実際に開く形式で何が働いたか走行メモを保つ。Are.naボードはこれに適しており、プレーン・テキスト・ファイルも。ポイントは3番目のプロンプトが2番目のプロンプトの勝者から始まること、ゼロからではない。
そして最初ミュート。きれいなサウンドトラックがそれを赦す前に動きを単独で判断。
今夜試す
上記3つのシーンの一つを選び、1つモデルで実行、カメラ行だけを変更。3回実行:スタティック、プッシュ・イン、トラッキング。クリップを並べる。その10分のこの実験からリスト100のプロンプトより学ぶ。
プロンプトをコピー、ドロップして、何が壊れるか見る。そして、最初に直す5スロットはどれか教えて。